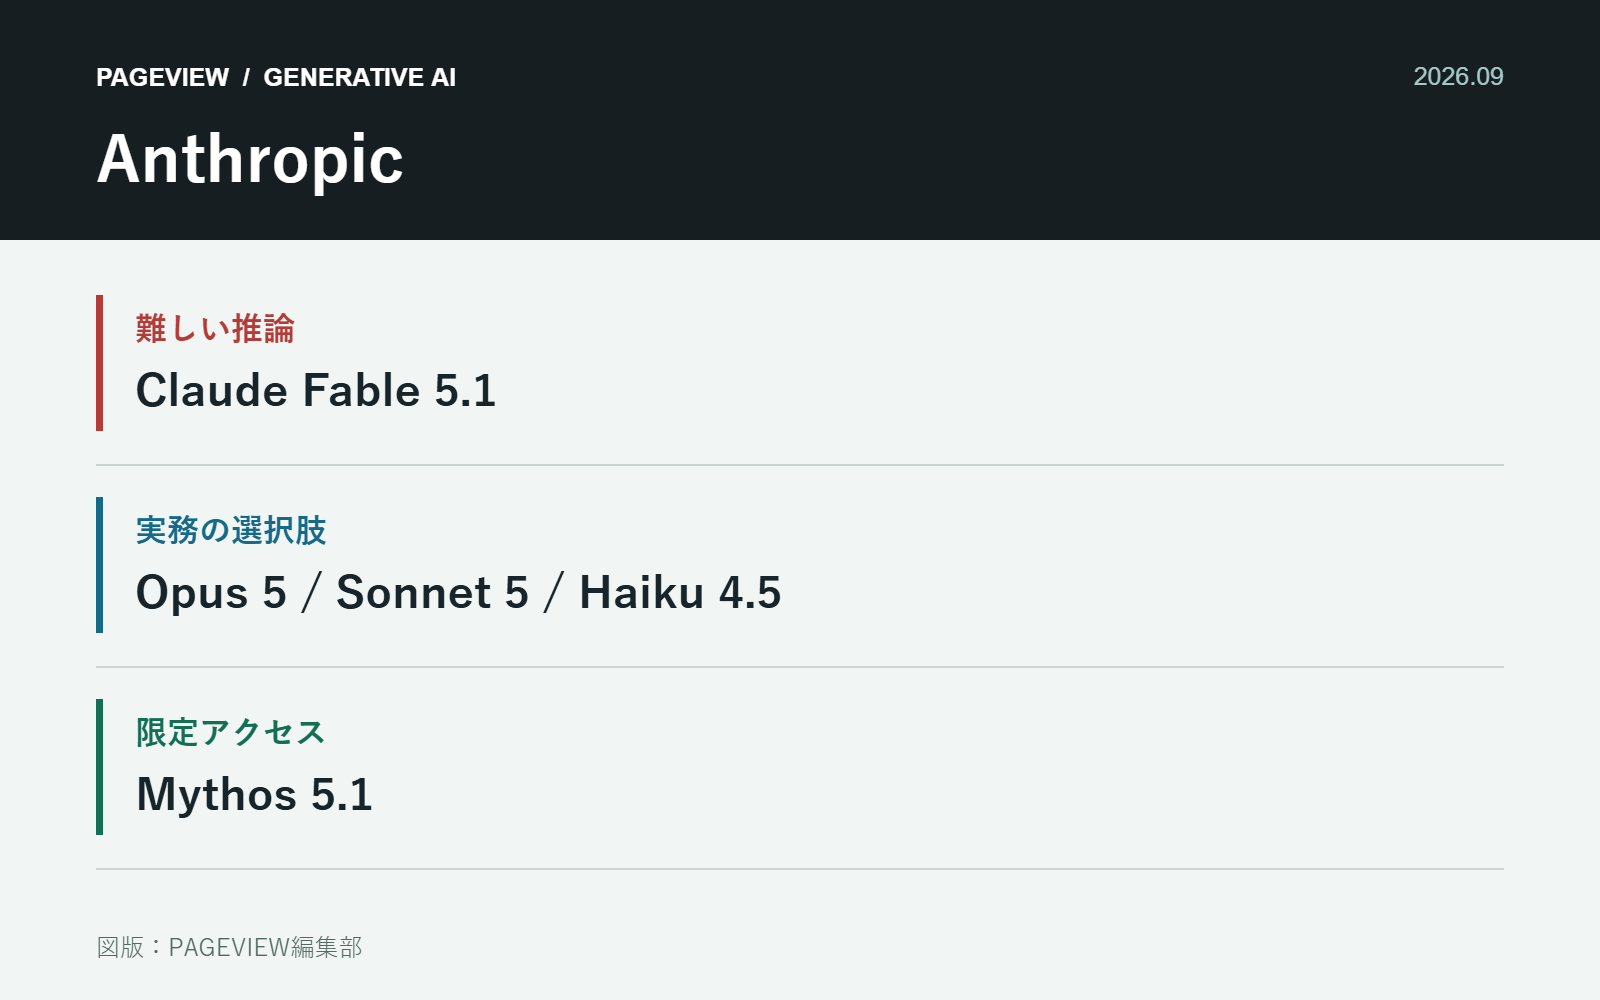
生成AI特集 / 3社の動向 / 2026年9月14日確認
Anthropicは2026年9月1日、Claude Fable 5.1とClaude Mythos 5.1を発表した。同社の説明では両者は同じ基盤モデルであり、安全対策と利用資格の設計が異なる。Fable 5.1は一般提供、Mythos 5.1は審査を伴うアクセス枠が中心だ。「Claudeの最上位モデル」という一つの言葉でまとめると、実際に使えるものと、対象が限られるものを取り違える。
日常の仕事では、FableだけでなくOpus 5、Sonnet 5、Haiku 4.5も選択肢になる。最新の名前を追うこと以上に、どのモデルにどこまでの仕事を任せるかが重要である。
Fableは難しい仕事、Opusは幅広い実務の基準に
公式のモデル選択案内は、多くの作業ではOpus 5から始め、難しい推論や長時間のエージェント作業で不足がある場合にFable 5.1を検討する構成になっている。Sonnet 5は速度と処理能力の両立、Haiku 4.5は軽量な処理を担う位置づけだ。
| モデル | 提供元が想定する主な役割 | APIのコンテキスト上限 |
|---|---|---|
| Fable 5.1 | 難しい推論、長い工程を伴う作業 | 100万トークン |
| Opus 5 | 複雑な開発、企業の実務 | 100万トークン |
| Sonnet 5 | 速度と能力のバランス | 100万トークン |
| Haiku 4.5 | 軽量・高速な処理 | 20万トークン |
これはAPI仕様の表であり、Claudeの一般向け画面に同じ上限がそのまま適用されるという意味ではない。長い文書を扱う担当者は、モデルの理論上限に加えて、契約プランと実際の入力画面の制限を確認する必要がある。
Fable 5.1の費用は「全トークンが値下げ」ではない
Fable 5.1では、すでに処理した入力を再利用するキャッシュ読み出しが、100万トークン当たり0.25ドルになった。通常入力10ドル、出力50ドルは維持されている。長い前提や履歴を繰り返し参照する作業ほど、この違いが費用に効く。
反対に、毎回内容が異なる短い依頼を一度ずつ処理するだけなら、キャッシュの効果は限られる。提供元が示す平均的な削減率を、そのまま自社の請求額に当てはめることはできない。入力、キャッシュの書き込み、読み出し、出力を分けた使用記録が必要である。
Sonnet 5にも注意したい。導入時に期限付きとされていた入力2ドル・出力10ドルの単価は、現在の料金表では標準価格として継続されている。過去の「9月から値上げ」という前提で予算を組んだままにすると、現状とのずれが生じる。
サブスクのFable利用条件は、APIとは違う
Claudeの料金ページでは、ProでのFable利用は利用クレジット、Maxでは週次上限の一部という形で条件が示されている。一般提供という表現は、すべての有料プランで同じ量を追加負担なく使えるという意味ではない。
また、ClaudeのチャットとClaude Codeなどを併用する場合は、どの利用が共通の枠を消費するかも確認したい。日中の資料作成で枠を使い、夜の開発作業で上限に達する運用では、モデル選択よりも利用配分が問題になる。使用履歴を一週間ほど見て、重い処理が集中する時間帯と仕事の種類を把握する方が判断しやすい。
Mythosは通常の比較ランキングから外す
Mythos 5.1は、サイバー防御やライフサイエンスの専門業務を想定したアクセス制度の対象である。発表時点では利用組織に地域などの制約もあり、通常のClaude API契約だけで自由に選べるモデルとは扱いが異なる。性能の紹介と購入・利用の可否は分けて読む必要がある。
企業が比較表を作るなら、まず「現在契約できるもの」「申請・審査が必要なもの」「今後の提供予定」の三つを分ける。自社では使えないモデルを首位に置いても、調達判断の材料にはならない。
判断すべきは、長い作業の途中で何が起きるか
Claudeを開発や業務のエージェントとして使う場合、最終回答だけでは品質を測れない。作業中に不要なファイルへ触れていないか、失敗後に同じ操作を繰り返していないか、人の承認が必要な場面で止まれるかを見る必要がある。コードの修正が完成しても、既存のテストを壊していれば実務上の成功ではない。
評価用の作業には、正常な依頼だけでなく、資料不足、矛盾する条件、権限外の操作を含める。解ける仕事を増やすだけでなく、解けないときに適切に止まることまで確認して初めて、モデルを一段上げる価値が判断できる。